原文:Moving a Rust WebRTC SFU to thread-per-core
概述:作者最近将他们的 WebRTC SFU 服务从 Tokio 默认的多线程工作窃取模型切换到了 thread-per-core(每核一线程)架构,将 P99.99 端到端延迟从偶尔冲到 70 ms 降至稳定的 10 ms,同时将系统容量提高了 25%。这里的 P99.99 是指 99.99% 的延迟样本不超过该值。
WebRTC SFU
WebRTC SFU,即 Web Real-Time Communication Selective Forwarding Unit,基于 WebRTC 协议的选择性转发单元。比如三人彼此视频聊天,这个项目承担的就是接收并转发视频数据流的工作,因此需要高性能和极低的延迟。
早期设计
第一版 SFU 基于 Rust 的 Tokio 多线程调度器实现,并依照 CSP 并发模型建立了最直观的抽象:每个 participant、room、controller 和 API 都有对应的 task,这些任务通过 channel 交流。
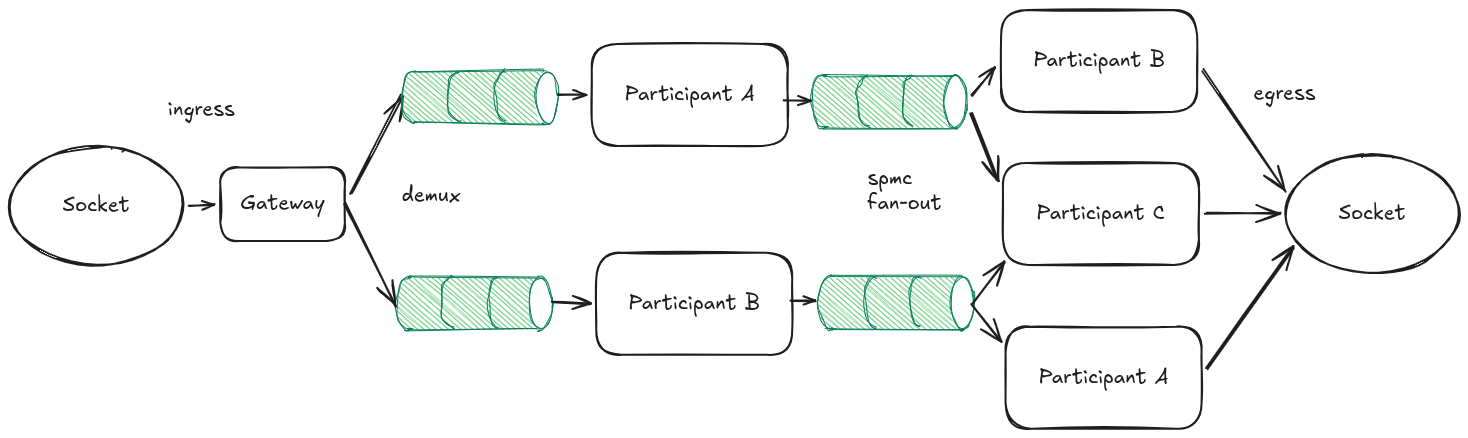
图:每次在任务之间传递数据,都要经过一次 channel。
低负载时,系统工作得很好。但是在 4 核设备上运行模拟四人全交互会议的基准测试时,问题开始暴露:WebRTC 统计数据显示,入站 RTP(Real-time Transport Protocol)流的抖动不断增大且不稳定,拖低了拥塞控制器的带宽估计值,最后造成画面卡顿。此时 CPU 占用率只有 80%,火焰图看起来也没有明显异常,唯独 Tokio 的任务窃取次数高得异常。
深入研究 Tokio 调度器的内部实现 后,作者发现罪魁祸首是在热路径上派生了过多的异步任务。
每次通过 channel 收发消息,都可能成为一个让出执行权的位置:执行器可能挂起当前任务,转而运行其他任务。在 Tokio 的工作窃取调度器中,这个“其他任务”可能只是另一个刚刚到达的数据包。一个已经接近处理完成的包,反而可能被一个才刚刚进入流水线的包插队。
WebRTC 数据包通常很小,大约为 500~1200 字节。因此,channel、调度和任务切换等每个包都会承担的固定开销会迅速累积。
解决方案
得益于 str0m 库不对线程和时间管理方式作出假设,作者团队可以轻松更换并发模型,而不需要重写整个媒体栈。
str0m是一个 WebRTC 协议实现,包括:
- SDP Offer/Answer 协商
- ICE 连接建立
- DTLS 与 SRTP 加密
- RTP/RTCP 收发与封包
- 音视频帧和 RTP 数据包接口
- Data Channel
- NACK 与关键帧请求
- Simulcast
- Transport-wide Congestion Control
- 带宽估计和统计信息
这些功能不是本文的重点,因而不作展开。
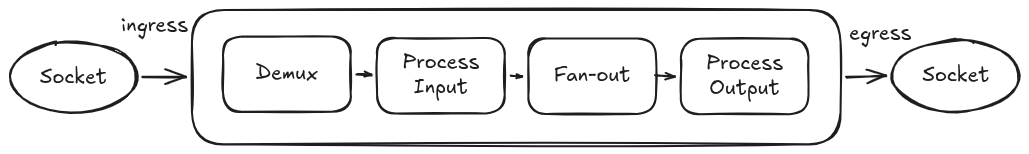
图:接收、分流、处理和发送都在同一个任务中同步完成。
既然问题出在异步调度,那么解决方法也很直观:移除热路径上的 channel,把每个包的若干处理流程合并成一个同步执行的任务。相比负载差异很大的典型 HTTP 请求,WebRTC SFU 的负载基于数据流、更加可预测,天然更适合每核一线程的设计。
这种方法并不罕见,Redpanda、Iggy 和 ScyllaDB 等项目也采用了类似的每核分片模式,以保持延迟可控。
其他 SFU 根据各自不同的目标选择了不同的方法:
| SFU | 并发架构 | 优势 | 代价 |
|---|---|---|---|
| LiveKit | Go 工作窃取,多核心共享任务 | 自动均衡负载,CPU 利用率高 | 共享状态需要锁,调度更不稳定 |
| mediasoup | 每核一个进程 | 隔离彻底,缓存局部性很好 | 多进程和 IPC 更复杂、更耗内存 |
| PulseBeam | 每核一个线程 | 接近进程级隔离,但仍在同一进程 | 跨核心通信和静态负载均衡较难 |
没有哪个方案是完美的。为了以基本无锁的方式实现更低的延迟,作者引入了更复杂的跨核心通信、更困难的负载均衡,以及某个高负载连接在管理不当时占满整个核心的风险。
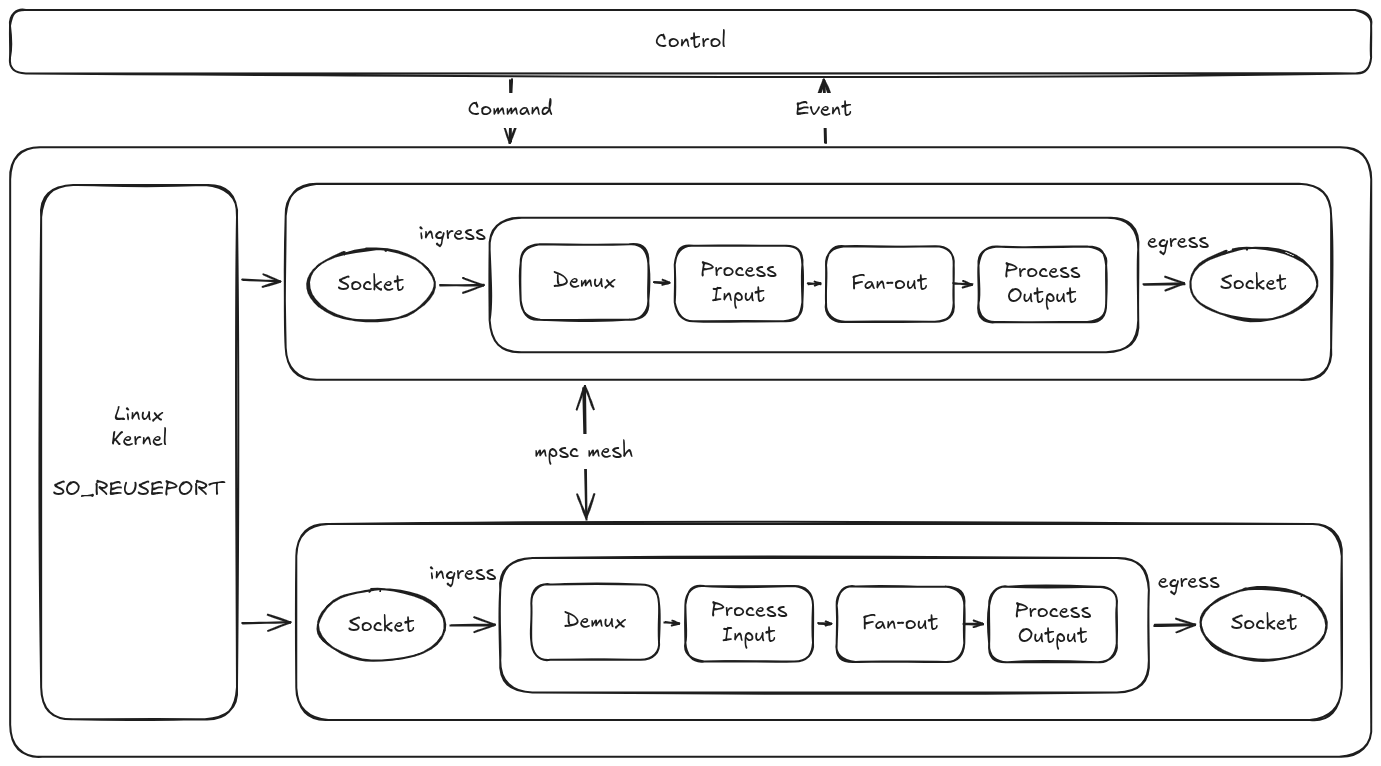
图:每个数据线程拥有一个分片,控制线程负责 SDP 协商和流量准入。
具体实现上,作者为每个数据线程启动一个 Tokio LocalRuntime。这并不是最符合每核一线程架构的运行时;compio、glommio 和 monoio 等基于 io_uring 的运行时才是为这种模型设计的。不过,Tokio 更加成熟且拥有庞大的生态,作者也希望避免把时间花在排查异步运行时层面的 Bug 上。
控制线程负责 SDP 协商(Session Description Protocol,会话描述协议,用于协商并确定媒体通信参数)、节点状态记录、流量速率控制和任务分配。如果数据线程已经达到最大容量,它会延迟或拒绝新的流量。
各个 shard(分片,在当前架构中严格绑定到一个 CPU 核心)通过网状结构通信,为此重新引入了 channel。不过,它的使用受到严格限制:消息最多只经历一次 channel hop,理想情况下则一次也不需要。
基准测试
客户端采用 Rust 编写。每个房间有 4 名全交互式参与者,每人向其他参与者发送一路 360p@30 的视频流,码率约为 400 Kbps。所有参与者均发布同一段预先编码的 H.264 视频,因此不涉及编码或解码。为降低波动性,Simulcast 处于禁用状态。
测试每秒新建一个房间,参与者在 15 秒的时间窗口内均匀加入,以模拟真实用户的到达模式。系统达到 120 个房间后停止创建新房间。在此峰值下,系统承载 480 名并发参与者,并在工作窃取调度器下使 CPU 使用率维持在约 80%。客户端采集两项关键指标:ICE 往返时延和端到端延迟。
- H.264:一种有损视频压缩标准。测试直接重放预先编码的视频,不进行实时编解码。
- Simulcast:同步联播,让客户端同时发送同一视频的多个不同质量或分辨率版本。
- ICE round-trip time:ICE 往返时延。
服务器运行在 4 个隔离的 i9-12900HK 性能核(P-core)上,核心降频至 1.8 GHz,并关闭超线程与睿频加速,以模拟注重成本的实际部署所采用的低配硬件。CPU 隔离通过以下内核参数实现:isolcpus=1-4 nohz_full=1-4 rcu_nocbs=1-4。
ICE 往返时延
ICE RTT 的测量没有扇出过程:服务器收到一个 STUN Binding Request 后,只向请求来源回复一个 STUN Binding Response。发送端收到响应后,即可计算往返时延(RTT)。
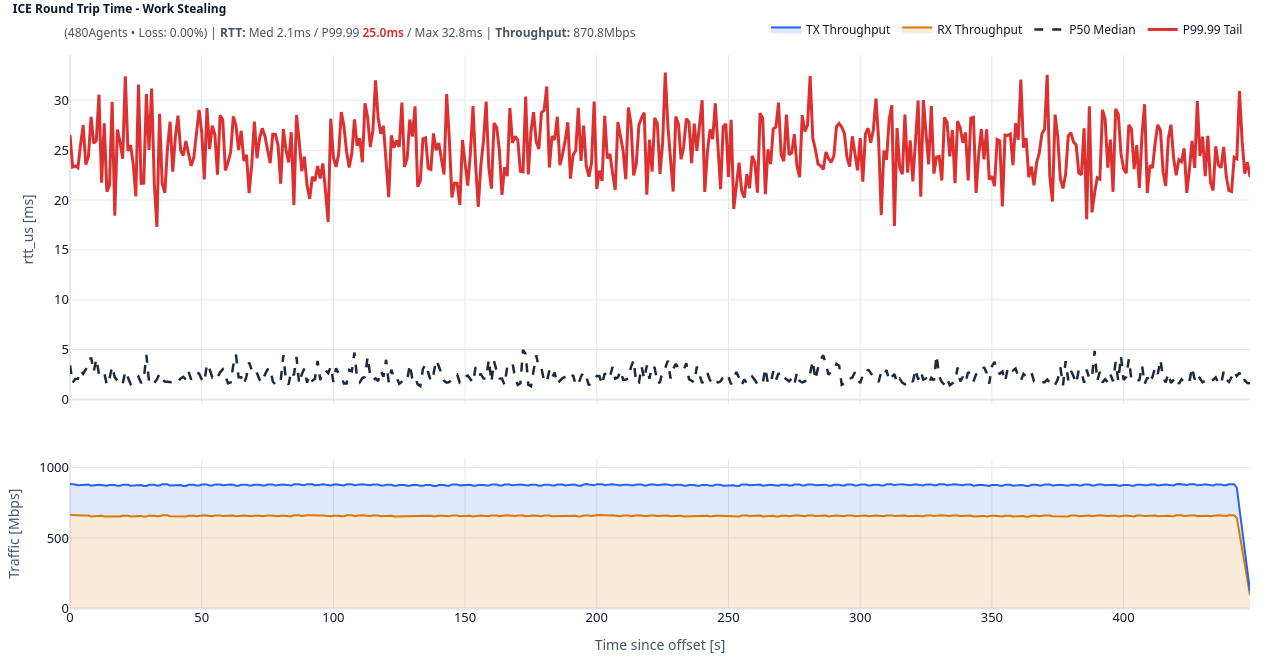
图:修改前,工作窃取 Tokio 下的 ICE RTT 分布。P99.99 尾延迟明显高于 P50。
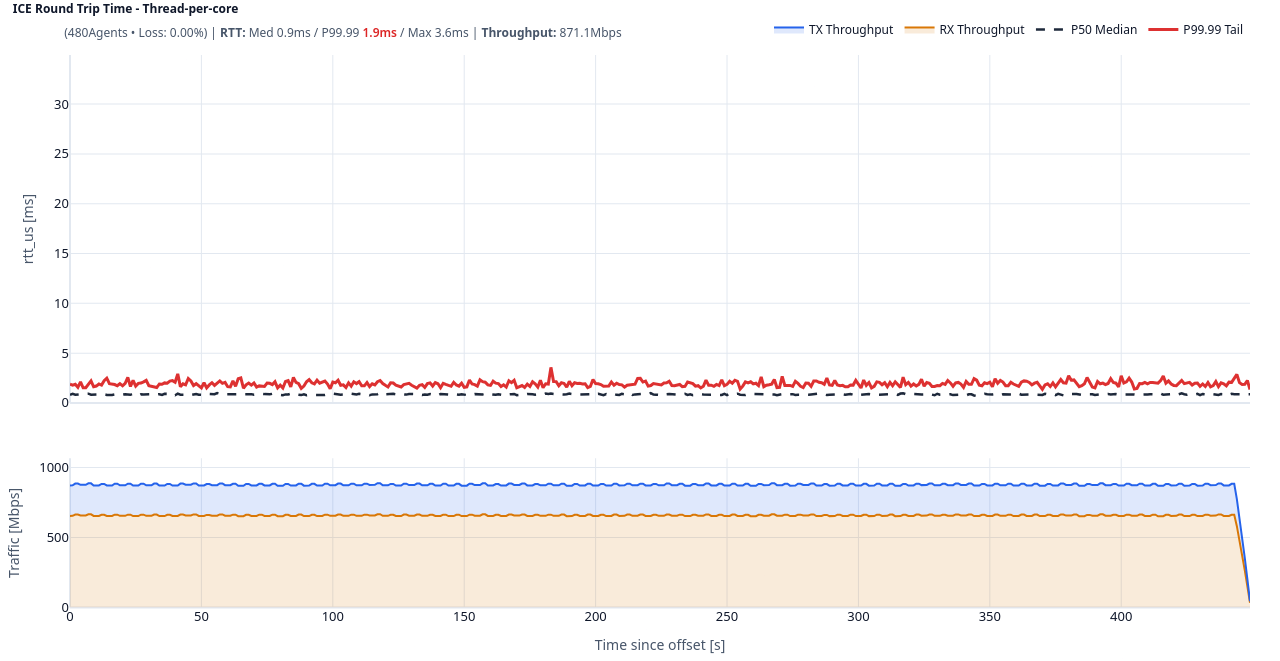
图:改为每核一线程后,ICE RTT 的分布更加集中。
端到端延迟
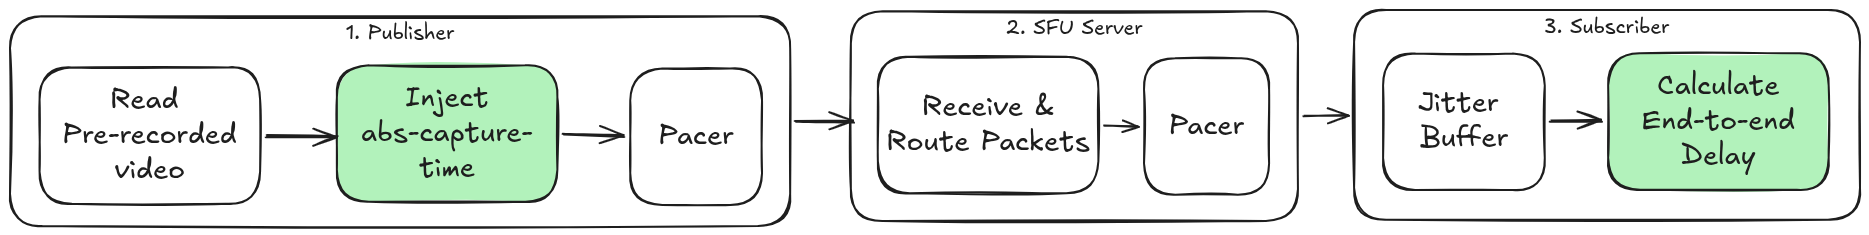
图:通过 abs-capture-time 头部扩展推导端到端延迟。
对于每一帧,发布端都会通过 abs-capture-time 头部扩展,将当前的单调时钟值注入 RTP 包。由于订阅端与发布端运行在同一台机器上,可以直接用接收时间减去该帧的 abs-capture-time,从而准确计算端到端延迟。
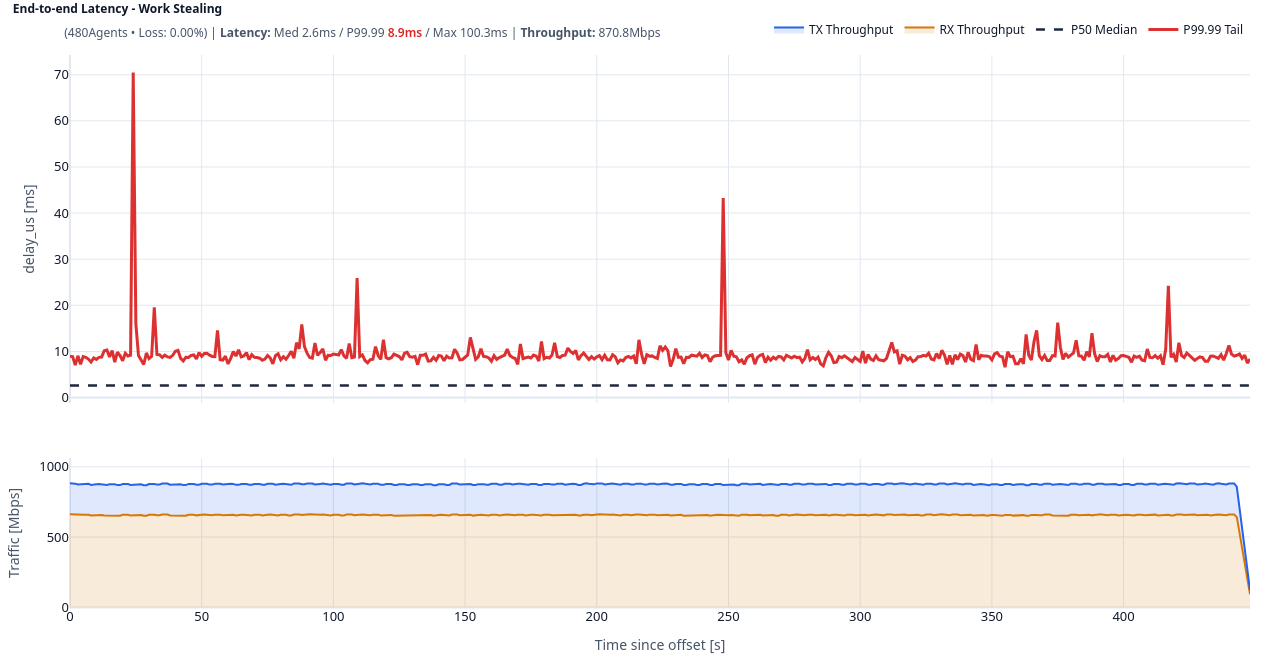
图:工作窃取 Tokio 下的端到端延迟分布,P99.99 尾延迟很不稳定。
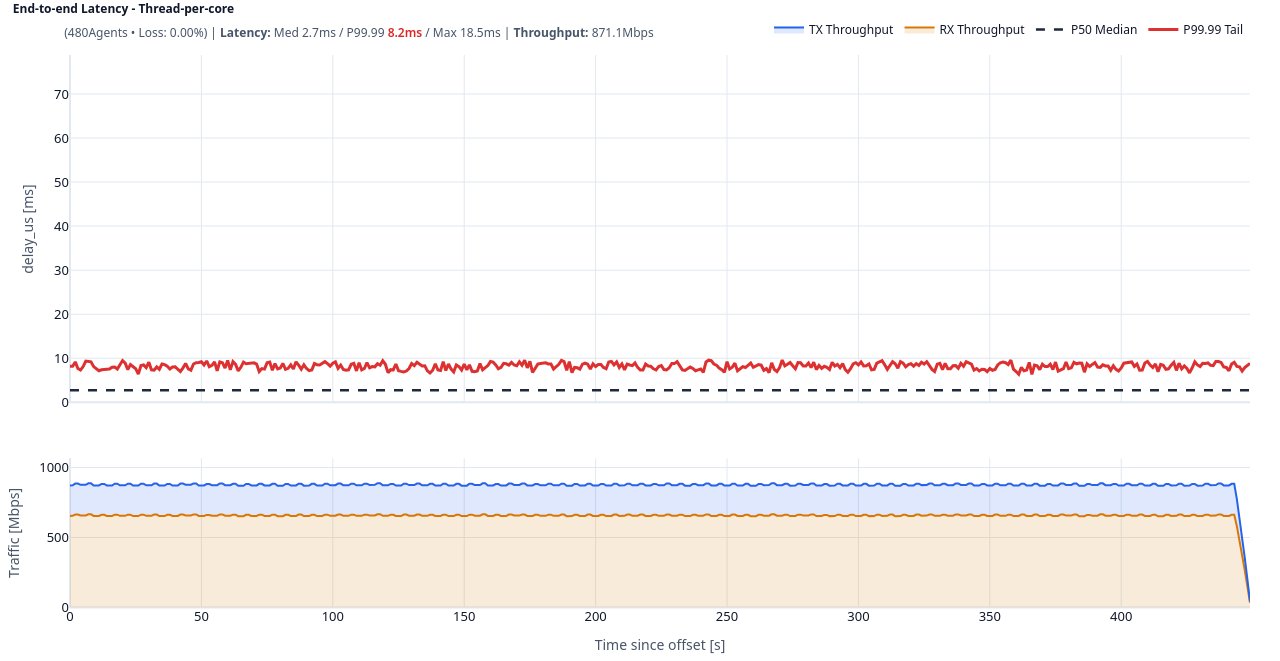
图:改为每核一线程后,尾延迟明显稳定了。
额外测试:每核一线程架构达到 80% CPU
将负载提高到 150 个房间后,CPU 占用率达到 80%,但测试中的延迟依旧稳定。此时,服务器的瓶颈已经从 CPU 转移到了网卡。
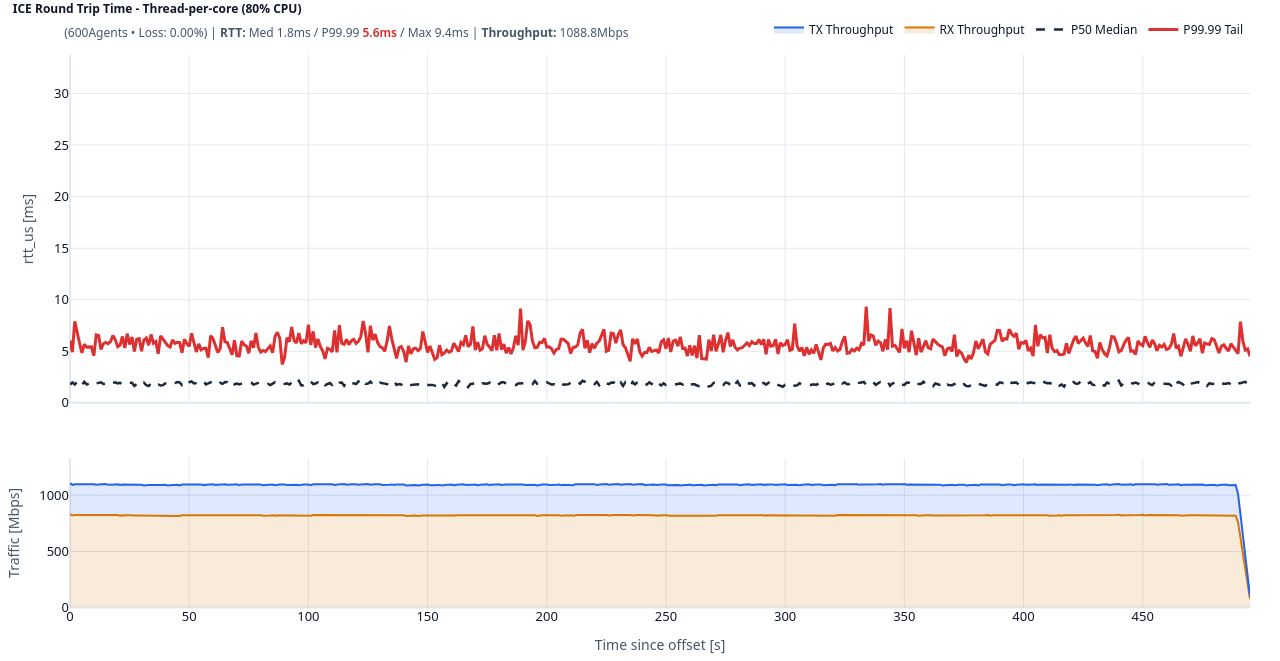
图:每核一线程架构达到 80% CPU 时的 ICE RTT 分布。
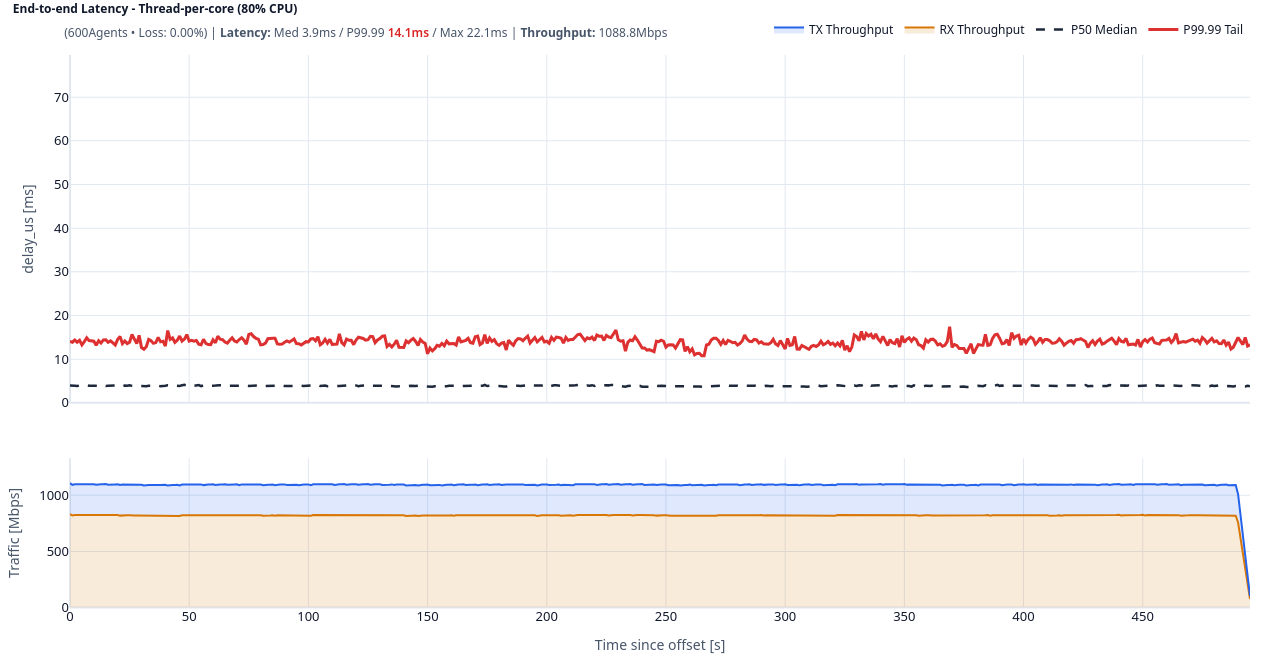
图:每核一线程架构达到 80% CPU 时的端到端延迟分布。
展望
thread-per-core 架构下还有更多值得探索的内容:
- 使用
io_uring减少系统调用和内存复制 - 使用 eBPF RSS steering(Receive Side Scaling,接收端扩展)避免数据包跨核心处理
- 比较面向对象(OOP)与实体组件系统(ECS),以改善 CPU 缓存行为
总结
许久没有更新了。之所以选择这一篇分享,是因为本文展现了一个相对完整且专业的“系统设计—性能缺陷—优化测试”流程。从并发模型的选择,到问题的诊断方法和优化方案,再到基准测试的设计……很多细节都值得学习。